
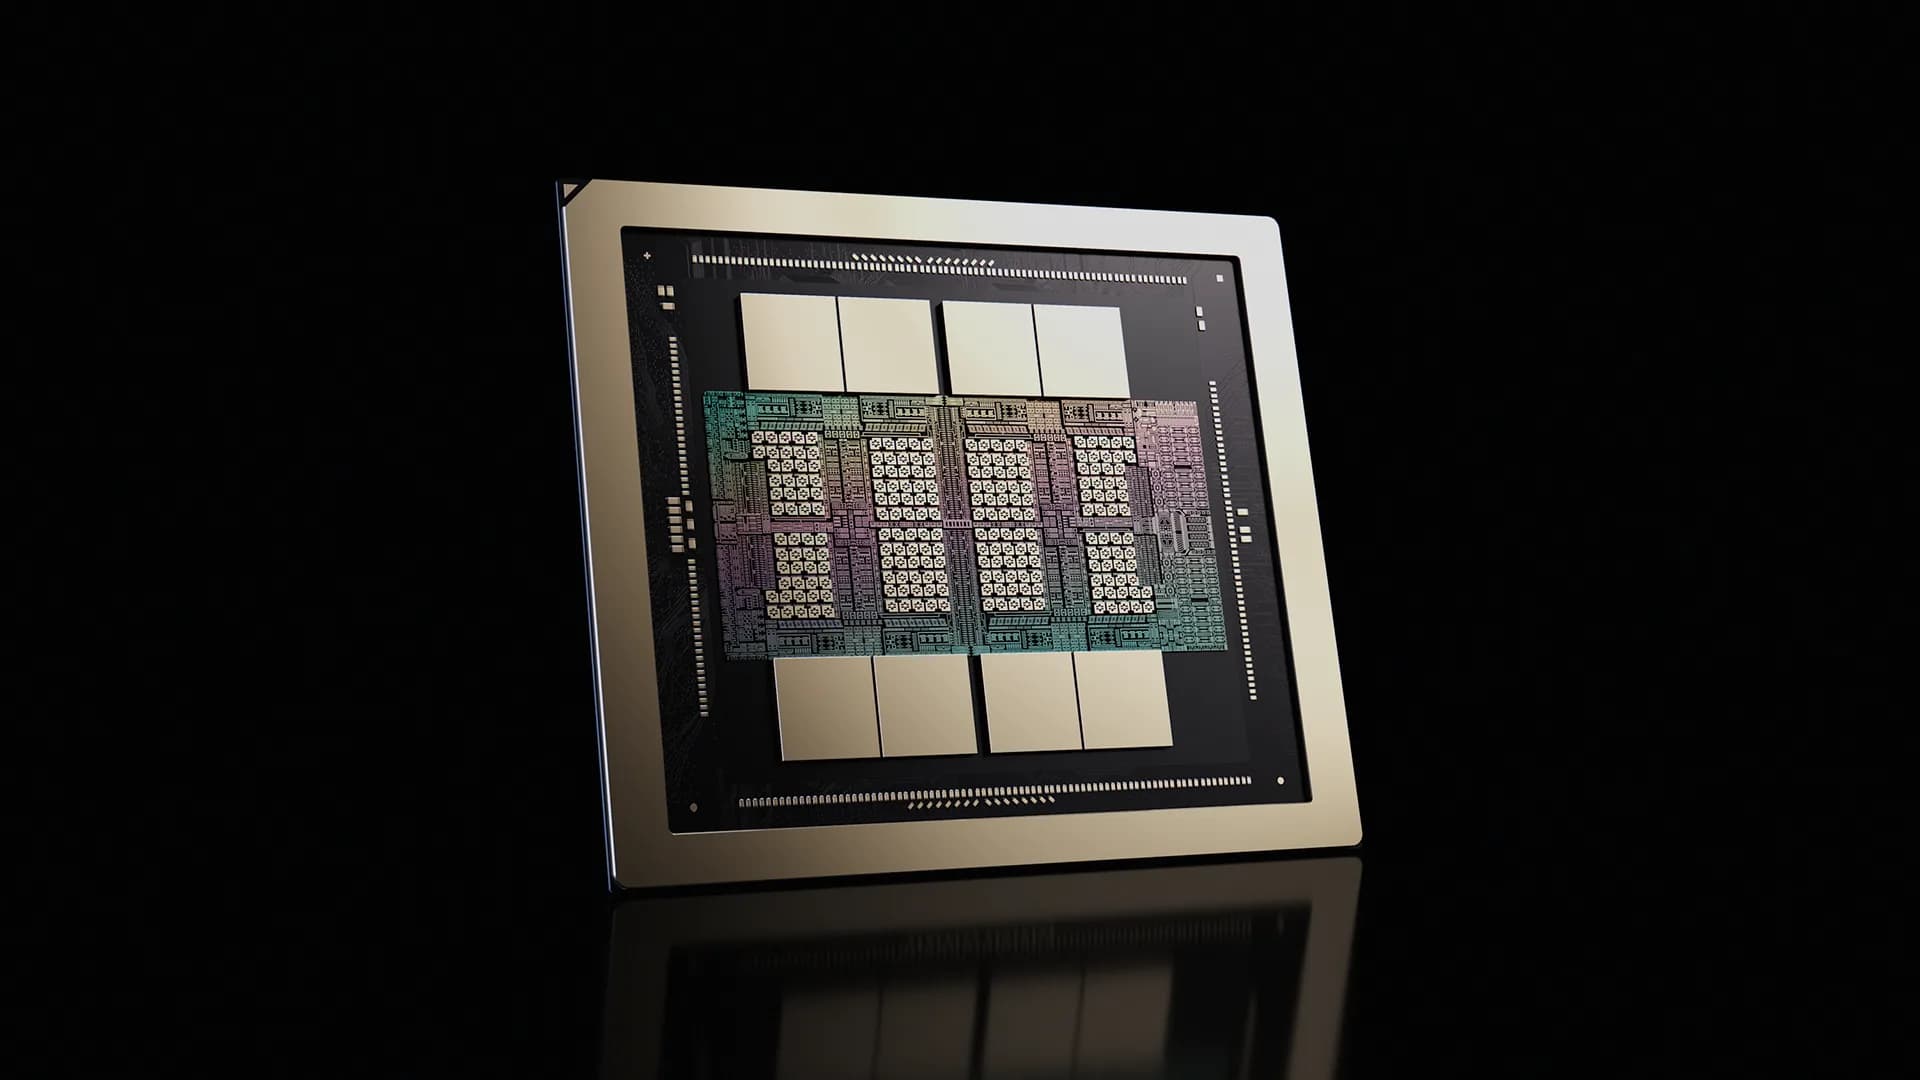
Melansir laporan industri yang diulas oleh Wccftech, NVIDIA diam-diam telah merevisi spesifikasi platform komputasi AI Vera Rubin generasi berikutnya , mengurangi bandwidth memori HBM4 dan bandwidth NVLink generasi keenam di berbagai konfigurasi sambil meningkatkan kemampuan jaringan skala besar. Menariknya, perubahan tersebut tampaknya telah dilakukan lebih dari sebulan yang lalu, bukan baru-baru ini.
Revisi tersebut, yang disoroti oleh Guru3D dan ITHome , dikonfirmasi dengan membandingkan spesifikasi Vera Rubin NVL72 terbaru dari NVIDIA dengan versi arsip dari halaman web yang sama.
Secara spesifik, cuplikan Wayback Machine dari tanggal 1 September dan 11 September 2026 mengungkapkan bahwa NVIDIA merevisi spesifikasi yang dipublikasikan di antara tanggal-tanggal tersebut, tanpa membuat pengumuman publik.
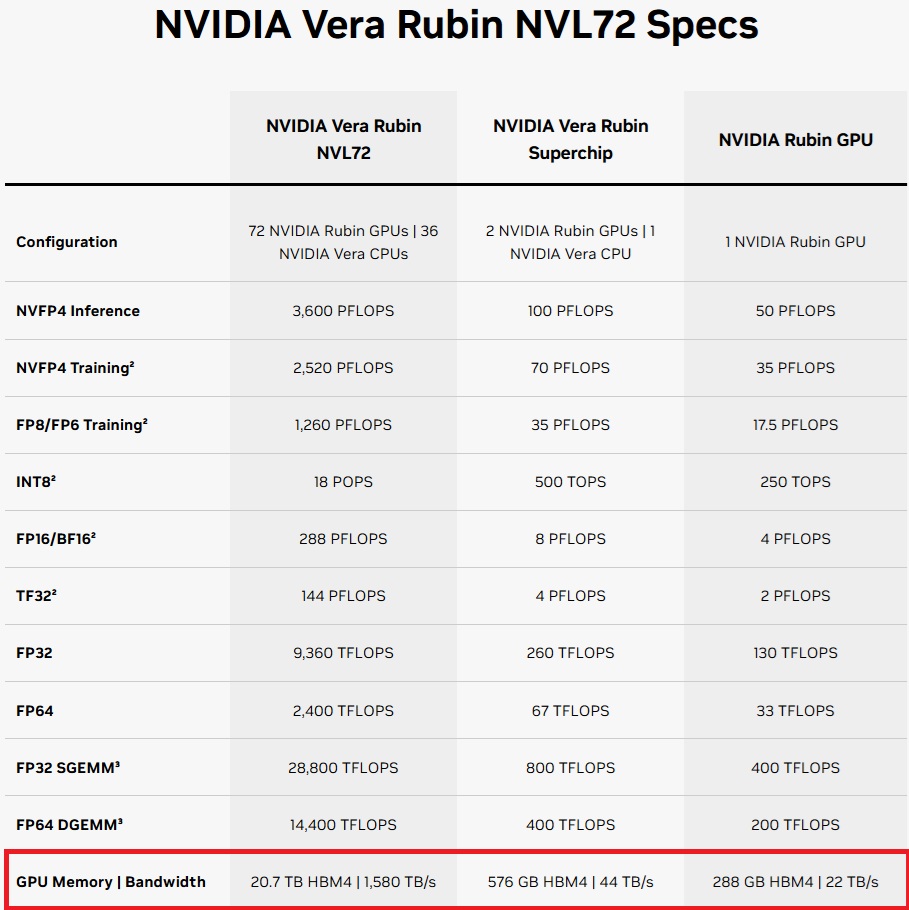
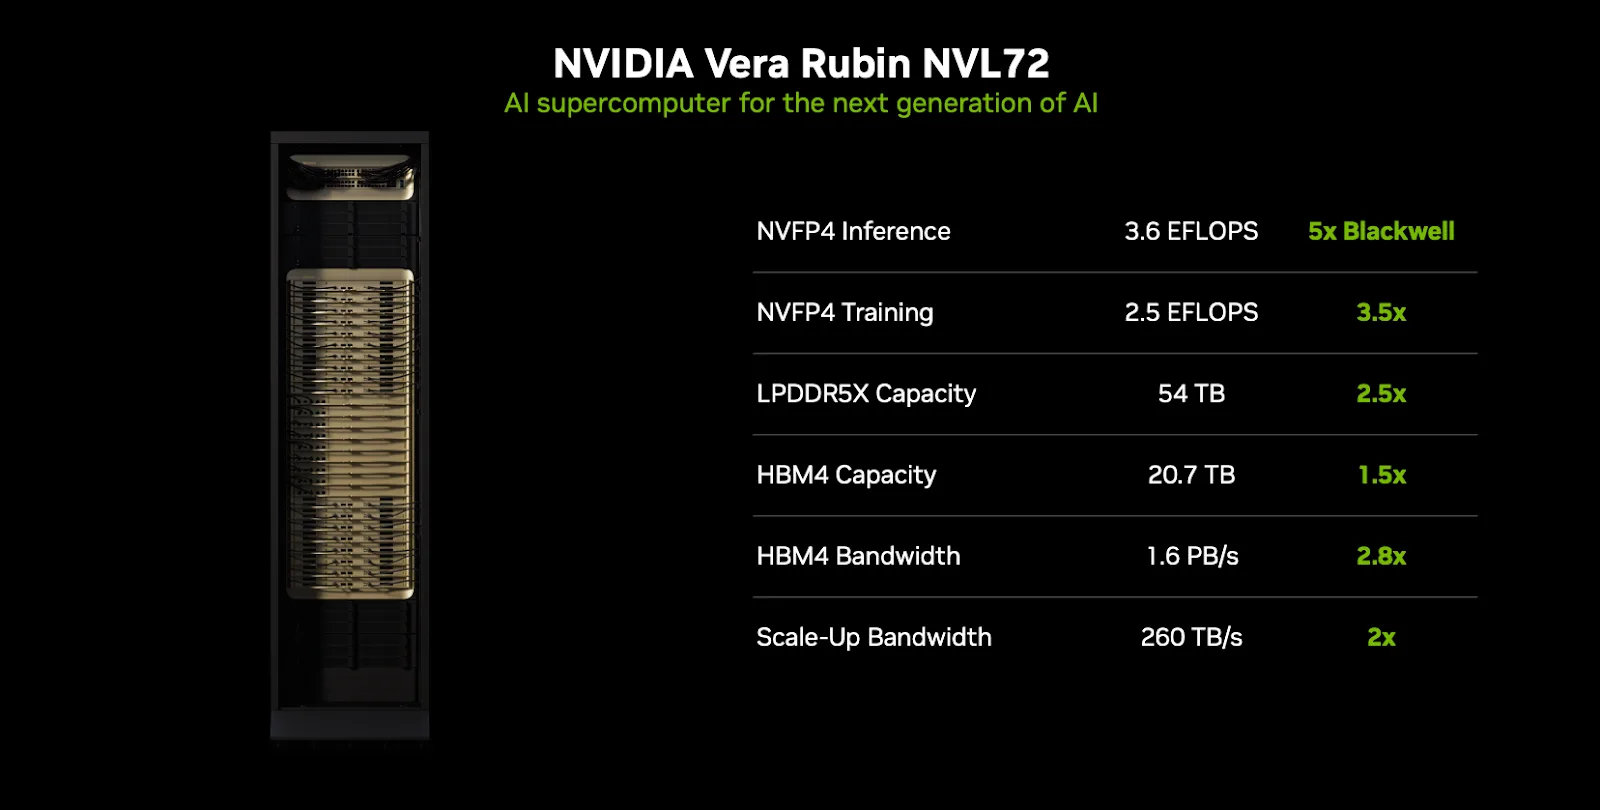
Seperti yang telah kami laporkan sebelumnya setelah presentasi NVIDIA di GTC 2026 , setiap GPU Rubin awalnya diiklankan dengan memori HBM4 288 GB yang memberikan bandwidth 22 TB/s , bersamaan dengan bandwidth NVLink 6 sebesar 3,6 TB/s . Angka-angka tersebut kemudian dikurangi menjadi 19,2 TB/s dan 3 TB/s , sehingga mewakili penurunan sekitar 13% dan 17% secara berturut-turut.
Perubahan tersebut meluas ke konfigurasi Vera Rubin NVL72 yang masif , yang menggabungkan 72 GPU Rubin dan 36 CPU Vera , serta sistem HGX Rubin NVL8 yang lebih kecil dari NVIDIA.
Spesifikasi NVIDIA Vera Rubin: Versi Sebelumnya vs. Versi Revisi
Configuration / Specification | Previous | Revised | Change |
|---|---|---|---|
Rubin GPU | | | |
HBM4 capacity | 288 GB | 288 GB | Unchanged |
HBM4 bandwidth | 22 TB/s | 19.2 TB/s | −12.7% |
NVLink 6 bandwidth | 3.6 TB/s | 3 TB/s | −16.7% |
Vera Rubin Superchip | | | |
HBM4 bandwidth | 44 TB/s | 38.5 TB/s | −12.5% |
NVLink bandwidth | 7.2 TB/s | 6 TB/s | −16.7% |
Networking bandwidth | 0.8 TB/s | 0.9 TB/s | +12.5% |
Vera Rubin NVL72 | | | |
HBM4 capacity | 20.7 TB | 20.7 TB | Unchanged |
HBM4 bandwidth | 1,580 TB/s | 1,400 TB/s | −11.4% |
NVLink bandwidth | 260 TB/s | 216 TB/s | −16.9% |
Networking bandwidth | 28.8 TB/s | 32.4 TB/s | +12.5% |
HGX Rubin NVL8 | | | |
HBM4 capacity | 2.3 TB | 2 TB | −13.0% |
HBM4 bandwidth | 176 TB/s | 130 TB/s | −26.1% |
NVLink Switch bandwidth | 28.8 TB/s | 24 TB/s | −16.7% |
Networking bandwidth | 1.6 TB/s | 1.8 TB/s | +12.5% |
NVFP4 training | 280 PFLOPS | 270 PFLOPS | −3.6% |
FP8/FP6 training | 140 PFLOPS | 130 PFLOPS | −7.1% |
Pengurangan paling signifikan terjadi pada bandwidth HBM4 agregat HGX Rubin NVL8, yang turun sekitar 26% , disertai dengan pengurangan kapasitas memori totalnya. Namun, NVIDIA telah meningkatkan bandwidth jaringan di seluruh konfigurasi, yang berpotensi menguntungkan komunikasi antar sistem yang terpisah .
Menariknya, dokumentasi NVIDIA tetap tidak konsisten. Halaman produk HGX mereka mencantumkan spesifikasi tingkat sistem yang telah direvisi, sementara masih mengiklankan angka asli 22 TB/s HBM4 dan 3,6 TB/s NVLink untuk masing-masing GPU Rubin. Beberapa halaman NVIDIA regional juga terus menampilkan spesifikasi lama.
Mengenai alasan di balik pengurangan tersebut, NVIDIA belum memberikan penjelasan resmi. Namun, laporan industri sebelumnya berdasarkan riset SemiAnalysis menunjukkan bahwa pemasok HBM4 kesulitan memenuhi target bandwidth awal NVIDIA . Pelonggaran persyaratan tersebut dapat meningkatkan hasil produksi dan membantu mengamankan pasokan memori yang cukup.
Yang lebih penting, perubahan tersebut menyangkut spesifikasi kinerja yang dipublikasikan NVIDIA, bukan hasil benchmark yang terukur. Kinerja inferensi sparse NVFP4 sebesar 50 PFLOPS yang diiklankan untuk GPU Rubin unggulan juga tetap tidak berubah, yang berarti dampak di dunia nyata akan sangat bergantung pada beban kerja individual dan sensitivitasnya terhadap memori dan bandwidth interkoneksi.
Ikuti Komputermedan di Google untuk mendapatkan lebih banyak liputan berita kami